یادگیری ماشین
خوشهبندی K-Means در OpenCV
هدف#
- یادگیری نحوه استفاده از تابع ()cv.kmeans در OpenCV برای خوشهبندی دادهها
درک پارامترها#
پارامترهای ورودی#
-
samples : نوع داده آن باید np.float32 باشد، و هر ویژگی (Feature) باید در یک ستون مجزا قرار گیرد.
-
nclusters(K) : تعداد خوشههای مورد نیاز در پایان
-
criteria : معیار خاتمه تکرار الگوریتم است. هنگامی که این معیار برآورده شود، تکرار الگوریتم متوقف میشود. در واقع، این پارامتر باید یک تاپل از ۳ پارامتر باشد:
( type, max_iter, epsilon ): 1. نوع معیار خاتمه. این معیار ۳ پرچم به شرح زیر دارد: - cv.TERM_CRITERIA_EPS - توقف تکرار الگوریتم در صورت رسیدن به دقت مشخصشده، epsilon. - cv.TERM_CRITERIA_MAX_ITER - توقف الگوریتم پس از تعداد مشخصی از تکرارها، max_iter. - cv.TERM_CRITERIA_EPS + cv.TERM_CRITERIA_MAX_ITER - توقف تکرار با برآورده شدن هر یک از شرایط فوق. 1. max_iter - عدد صحیحی که حداکثر تعداد تکرارها را مشخص میکند. 1. epsilon - دقت مورد نیاز -
attempts : پرچمی برای تعیین تعداد دفعاتی که الگوریتم با استفاده از برچسبگذاریهای اولیه متفاوت اجرا میشود. الگوریتم برچسبهایی را بازمیگرداند که بهترین فشردگی (Compactness) را به همراه دارند. این فشردگی به عنوان خروجی بازگردانده میشود.
-
flags : این پرچم برای تعیین چگونگی انتخاب مراکز اولیه استفاده میشود. معمولاً دو پرچم برای این کار استفاده میشوند: cv.KMEANS_PP_CENTERS و cv.KMEANS_RANDOM_CENTERS.
پارامترهای خروجی#
- compactness : مجموع مجذور فواصل هر نقطه تا مراکز متناظر آنها است.
- labels : این آرایه برچسبها است (مشابه 'code' در مقاله قبلی) که در آن هر عنصر با '0'، '1' و... مشخص شده است.
- centers : آرایهای از مراکز خوشهها است.
اکنون خواهیم دید که چگونه الگوریتم K-Means را با سه مثال اعمال کنیم.
۱. داده با تنها یک ویژگی#
فرض کنید مجموعهای از دادهها با تنها یک ویژگی دارید، یعنی تکبعدی است. به عنوان مثال، میتوانیم مسئله تیشرت خود را در نظر بگیریم که در آن فقط از قد افراد برای تصمیمگیری در مورد سایز تیشرت استفاده میکنید.
بنابراین با ایجاد دادهها و رسم آن در Matplotlib شروع میکنیم:
import numpy as np
import cv2 as cv
from matplotlib import pyplot as plt

x = np.random.randint(25,100,25)
y = np.random.randint(175,255,25)
z = np.hstack((x,y))
z = z.reshape((50,1))
z = np.float32(z)
plt.hist(z,256,[0,256]),plt.show()
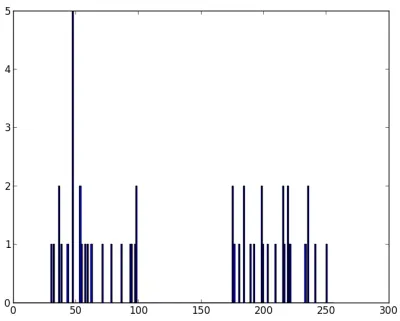
بنابراین ما 'z' را داریم که آرایهای به اندازه ۵۰ با مقادیر بین ۰ تا ۲۵۵ است. من 'z' را به یک بردار ستونی تغییر شکل (reshape) دادهام. این کار زمانی که بیش از یک ویژگی وجود داشته باشد مفیدتر خواهد بود. سپس دادهها را از نوع np.float32 ساختم.
تصویر زیر را به دست میآوریم:
اکنون تابع KMeans را اعمال میکنیم. قبل از آن باید معیار را مشخص کنیم. معیار من به این صورت است که هرگاه ۱۰ تکرار از الگوریتم اجرا شد یا به دقتی برابر با epsilon = 1.0 رسید، الگوریتم را متوقف کرده و پاسخ را برگرداند.
# Define criteria = ( type, max_iter = 10 , epsilon = 1.0 )
criteria = (cv.TERM_CRITERIA_EPS + cv.TERM_CRITERIA_MAX_ITER, 10, 1.0)

# Set flags (Just to avoid line break in the code)
flags = cv.KMEANS_RANDOM_CENTERS

# Apply KMeans
compactness,labels,centers = cv.kmeans(z,2,None,criteria,10,flags)
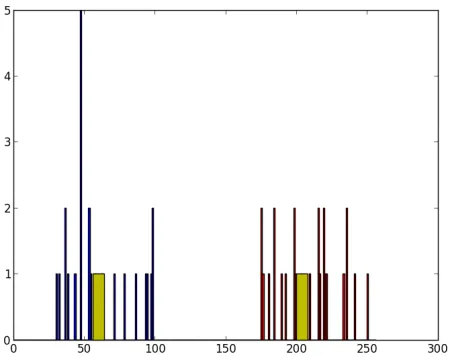
این تابع به ما میزان فشردگی (compactness)، برچسبها (labels) و مراکز (centers) را میدهد. در این مورد، من مراکز را ۶۰ و ۲۰۷ به دست آوردم. برچسبها اندازهای مشابه با دادههای آزمایشی خواهند داشت که در آن هر داده بسته به مراکز خوشهشان به صورت '0'، '1'، '2' و غیره برچسبگذاری میشود. اکنون دادهها را بر اساس برچسبهایشان به خوشههای مختلف تفکیک میکنیم:
A = z[labels==0]
B = z[labels==1]
اکنون A را به رنگ قرمز، B را به رنگ آبی و مراکز آنها را به رنگ زرد رسم میکنیم:
# Now plot 'A' in red, 'B' in blue, 'centers' in yellow
plt.hist(A,256,[0,256],color = 'r')
plt.hist(B,256,[0,256],color = 'b')
plt.hist(centers,32,[0,256],color = 'y')
plt.show()
در زیر خروجی حاصل آمده است:
۲. داده با چندین ویژگی#
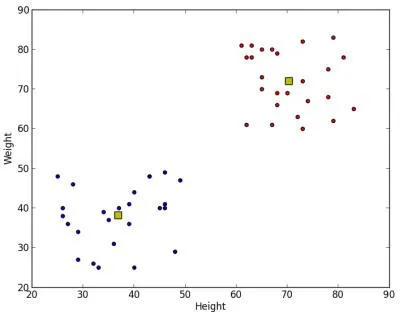
در مثال قبلی، برای مسئله تیشرت فقط قد را در نظر گرفتیم. در اینجا، هر دو پارامتر قد و وزن، یعنی دو ویژگی را در نظر خواهیم گرفت.
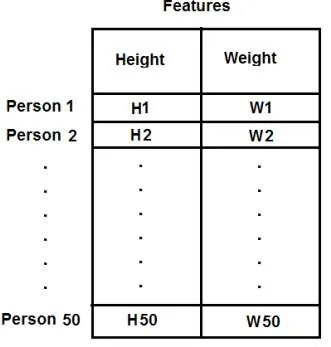
به یاد داشته باشید، در حالت قبل، دادههای خود را به یک بردار تکستونی تبدیل کردیم. هر ویژگی در یک ستون چیده میشود، در حالی که هر سطر متناظر با یک نمونه آزمایشی ورودی است.
برای مثال، در این مورد، داده آزمایشی به ابعاد 50x2 را تنظیم میکنیم که قد و وزن ۵۰ نفر است. ستون اول متناظر با قد تمام ۵۰ نفر و ستون دوم متناظر با وزن آنها است. سطر اول شامل دو عنصر است که اولی قد شخص اول و دومی وزن اوست. مشابهاً سطرهای باقیمانده متناظر با قد و وزن سایر افراد است. تصویر زیر را بررسی کنید:
اکنون مستقیماً به سراغ کد میرویم:
import numpy as np
import cv2 as cv
from matplotlib import pyplot as plt

X = np.random.randint(25,50,(25,2))
Y = np.random.randint(60,85,(25,2))
Z = np.vstack((X,Y))

# convert to np.float32
Z = np.float32(Z)

# define criteria and apply kmeans()
criteria = (cv.TERM_CRITERIA_EPS + cv.TERM_CRITERIA_MAX_ITER, 10, 1.0)
ret,label,center=cv.kmeans(Z,2,None,criteria,10,cv.KMEANS_RANDOM_CENTERS)

# Now separate the data, Note the flatten()
A = Z[label.ravel()==0]
B = Z[label.ravel()==1]

# Plot the data
plt.scatter(A[:,0],A[:,1])
plt.scatter(B[:,0],B[:,1],c = 'r')
plt.scatter(center[:,0],center[:,1],s = 80,c = 'y', marker = 's')
plt.xlabel('Height'),plt.ylabel('Weight')
plt.show()
در زیر خروجی به دست آمده را مشاهده میکنید:
۳. کوانتیزاسیون رنگ (Color Quantization)#
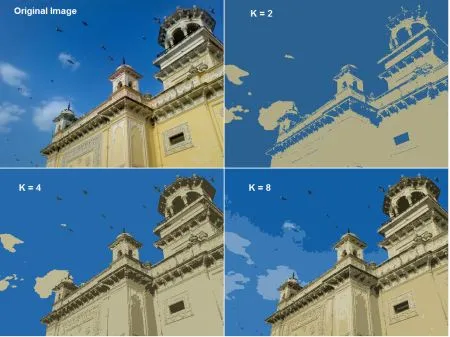
کوانتیزاسیون رنگ فرآیند کاهش تعداد رنگها در یک تصویر است. یک دلیل برای انجام این کار، کاهش مصرف حافظه است. گاهی اوقات برخی از دستگاهها ممکن است محدودیتی داشته باشند به گونهای که تنها بتوانند تعداد محدودی رنگ تولید کنند. در این موارد نیز کوانتیزاسیون رنگ انجام میشود. در اینجا ما از خوشهبندی k-means برای کوانتیزاسیون رنگ استفاده میکنیم.
مطلب جدیدی برای توضیح در اینجا وجود ندارد. ۳ ویژگی داریم، مثلاً R، G و B. بنابراین باید تصویر را به آرایهای به اندازه Mx3 تغییر بعد دهیم (M تعداد پیکسلهای تصویر است). و پس از خوشهبندی، مقادیر مرکز خوشه (که آن هم R، G و B است) را روی تمام پیکسلها اعمال میکنیم، به گونهای که تصویر حاصل دارای تعداد مشخصی رنگ باشد. و مجدداً باید شکل آن را به ابعاد تصویر اصلی برگردانیم. کد در زیر آمده است:
import numpy as np
import cv2 as cv

img = cv.imread('home.jpg')
Z = img.reshape((-1,3))

# convert to np.float32
Z = np.float32(Z)

# define criteria, number of clusters(K) and apply kmeans()
criteria = (cv.TERM_CRITERIA_EPS + cv.TERM_CRITERIA_MAX_ITER, 10, 1.0)
K = 8
ret,label,center=cv.kmeans(Z,K,None,criteria,10,cv.KMEANS_RANDOM_CENTERS)

# Now convert back into uint8, and make original image
center = np.uint8(center)
res = center[label.flatten()]
res2 = res.reshape((img.shape))

cv.imshow('res2',res2)
cv.waitKey(0)
cv.destroyAllWindows()
نتیجه را در زیر برای K=8 مشاهده کنید: