تشخیص و توصیف ویژگی
تطبیق ویژگی (Feature Matching)
هدف#
در این فصل
- خواهیم دید که چگونه ویژگیهای یک تصویر را با تصاویر دیگر تطبیق دهیم.
- از تطبیقدهنده Brute-Force و تطبیقدهنده FLANN در OpenCV استفاده خواهیم کرد.
مبانی تطبیقدهنده Brute-Force#
تطبیقدهنده Brute-Force ساده است. توصیفگر یک ویژگی را از مجموعه اول گرفته و با تمام ویژگیهای مجموعه دوم با استفاده از محاسبه فاصله تطبیق میدهد. نزدیکترین مورد بازگردانده میشود.
برای تطبیقدهنده BF، ابتدا باید شیء BFMatcher را با استفاده از cv.BFMatcher() ایجاد کنیم. دو پارامتر اختیاری دارد. پارامتر اول normType است که نوع اندازهگیری فاصله مورد استفاده را مشخص میکند. به طور پیشفرض cv.NORM_L2 است که برای SIFT، SURF و غیره مناسب است (cv.NORM_L1 نیز وجود دارد). برای توصیفگرهای مبتنی بر رشته دودویی مانند ORB، BRIEF، BRISK و غیره، باید از cv.NORM_HAMMING استفاده شود که از فاصله هَمینگ (Hamming distance) به عنوان معیار استفاده میکند. اگر ORB از WTA_K == 3 یا ۴ استفاده کند، باید از cv.NORM_HAMMING2 استفاده شود.
پارامتر دوم یک متغیر بولی به نام crossCheck است که به طور پیشفرض false است. اگر true باشد، تطبیقدهنده فقط تطبیقهایی با مقدار (i,j) را برمیگرداند که توصیفگر i-ام در مجموعه A، توصیفگر j-ام در مجموعه B را به عنوان بهترین تطبیق داشته باشد و بالعکس. یعنی دو ویژگی در هر دو مجموعه باید با یکدیگر تطبیق داشته باشند. این روش نتایج ثابتتری ارائه میدهد و جایگزین خوبی برای آزمون نسبت (ratio test) پیشنهادی D.Lowe در مقاله SIFT است.
پس از ایجاد، دو روش مهم BFMatcher.match() و BFMatcher.knnMatch() وجود دارند. روش اول بهترین تطبیق را برمیگرداند. روش دوم k بهترین تطبیق را برمیگرداند که k توسط کاربر مشخص میشود. این روش زمانی مفید است که نیاز به انجام کار اضافی داریم.
همانطور که از cv.drawKeypoints() برای رسم نقاط کلیدی استفاده کردیم، cv.drawMatches() به ما کمک میکند تا تطبیقها را رسم کنیم. این تابع دو تصویر را به صورت افقی کنار هم قرار میدهد و خطوطی از تصویر اول به تصویر دوم میکشد که بهترین تطبیقها را نشان میدهند. همچنین cv.drawMatchesKnn وجود دارد که تمام k بهترین تطبیق را رسم میکند. اگر k=2 باشد، دو خط تطبیق برای هر نقطه کلیدی رسم میکند. بنابراین اگر بخواهیم به صورت انتخابی رسم کنیم باید یک ماسک ارسال کنیم.
بیایید یک مثال برای هر یک از SIFT و ORB ببینیم (هر دو از اندازهگیری فاصله متفاوتی استفاده میکنند).
تطبیق Brute-Force با توصیفگرهای ORB#
در اینجا یک مثال ساده برای نحوه تطبیق ویژگیها بین دو تصویر خواهیم دید. در این حالت، یک queryImage و یک trainImage داریم. با استفاده از تطبیق ویژگی سعی میکنیم queryImage را در trainImage پیدا کنیم. (تصاویر /samples/data/box.png و /samples/data/box_in_scene.png هستند)
از توصیفگرهای ORB برای تطبیق ویژگیها استفاده میکنیم. پس بیایید با بارگذاری تصاویر و یافتن توصیفگرها و غیره شروع کنیم.
import numpy as np
import cv2 as cv
import matplotlib.pyplot as plt

img1 = cv.imread('box.png',cv.IMREAD_GRAYSCALE)          # queryImage
img2 = cv.imread('box_in_scene.png',cv.IMREAD_GRAYSCALE) # trainImage

# Initiate ORB detector
orb = cv.ORB_create()

# find the keypoints and descriptors with ORB
kp1, des1 = orb.detectAndCompute(img1,None)
kp2, des2 = orb.detectAndCompute(img2,None)
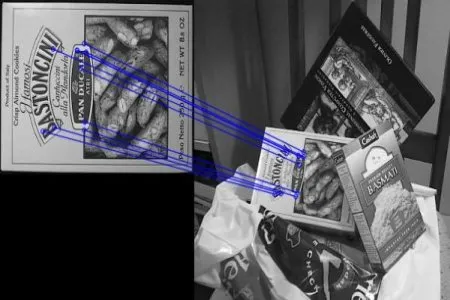
در مرحله بعد، یک شیء BFMatcher با اندازهگیری فاصله cv.NORM_HAMMING (چون از ORB استفاده میکنیم) ایجاد میکنیم و crossCheck برای نتایج بهتر روشن شده است. سپس از روش Matcher.match() برای به دست آوردن بهترین تطبیقها در دو تصویر استفاده میکنیم. آنها را به ترتیب صعودی فاصله مرتب میکنیم تا بهترین تطبیقها (با فاصله کم) در ابتدا قرار گیرند. سپس فقط ۱۰ تطبیق اول را رسم میکنیم (فقط برای قابلیت مشاهده. میتوانید آن را هر چقدر بخواهید افزایش دهید)
# create BFMatcher object
bf = cv.BFMatcher(cv.NORM_HAMMING, crossCheck=True)

# Match descriptors.
matches = bf.match(des1,des2)

# Sort them in the order of their distance.
matches = sorted(matches, key = lambda x:x.distance)

# Draw first 10 matches.
img3 = cv.drawMatches(img1,kp1,img2,kp2,matches[:10],None,flags=cv.DrawMatchesFlags_NOT_DRAW_SINGLE_POINTS)

plt.imshow(img3),plt.show()
نتیجه زیر را دریافت کردم:
شیء Matcher چیست؟#
نتیجه خط matches = bf.match(des1,des2) یک لیست از اشیاء DMatch است. این شیء DMatch دارای ویژگیهای زیر است:
- DMatch.distance - فاصله بین توصیفگرها. هرچه کمتر، بهتر است.
- DMatch.trainIdx - اندیس توصیفگر در توصیفگرهای train
- DMatch.queryIdx - اندیس توصیفگر در توصیفگرهای query
- DMatch.imgIdx - اندیس تصویر train.
تطبیق Brute-Force با توصیفگرهای SIFT و آزمون نسبت#
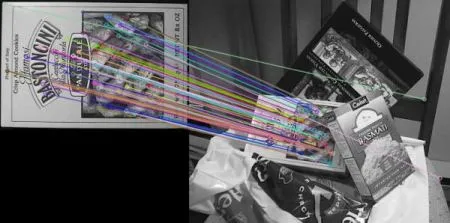
این بار از BFMatcher.knnMatch() برای به دست آوردن k بهترین تطبیق استفاده میکنیم. در این مثال k=2 میگیریم تا بتوانیم آزمون نسبت توضیح دادهشده توسط D.Lowe در مقالهاش را اعمال کنیم.
import numpy as np
import cv2 as cv
import matplotlib.pyplot as plt

img1 = cv.imread('box.png',cv.IMREAD_GRAYSCALE)          # queryImage
img2 = cv.imread('box_in_scene.png',cv.IMREAD_GRAYSCALE) # trainImage

# Initiate SIFT detector
sift = cv.SIFT_create()

# find the keypoints and descriptors with SIFT
kp1, des1 = sift.detectAndCompute(img1,None)
kp2, des2 = sift.detectAndCompute(img2,None)

# BFMatcher with default params
bf = cv.BFMatcher()
matches = bf.knnMatch(des1,des2,k=2)

# Apply ratio test
good = []
for m,n in matches:
    if m.distance < 0.75*n.distance:
        good.append([m])

# cv.drawMatchesKnn expects list of lists as matches.
img3 = cv.drawMatchesKnn(img1,kp1,img2,kp2,good,None,flags=cv.DrawMatchesFlags_NOT_DRAW_SINGLE_POINTS)

plt.imshow(img3),plt.show()
نتیجه را در زیر ببینید:
تطبیقدهنده مبتنی بر FLANN#
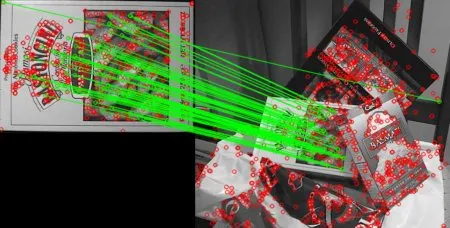
FLANN مخفف Fast Library for Approximate Nearest Neighbors است. این کتابخانه مجموعهای از الگوریتمهای بهینهسازیشده برای جستجوی سریع نزدیکترین همسایه (nearest neighbor) در مجموعهدادههای بزرگ و برای ویژگیهای چندبُعدی دارد. برای مجموعهدادههای بزرگ سریعتر از BFMatcher کار میکند. مثال دوم را با تطبیقدهنده مبتنی بر FLANN خواهیم دید.
برای تطبیقدهنده مبتنی بر FLANN، باید دو دیکشنری ارسال کنیم که الگوریتم مورد استفاده، پارامترهای مرتبط با آن و غیره را مشخص میکنند. اول IndexParams است. برای الگوریتمهای مختلف، اطلاعاتی که باید ارسال شود در مستندات FLANN توضیح داده شده است. به طور خلاصه، برای الگوریتمهایی مانند SIFT، SURF و غیره میتوانید موارد زیر را ارسال کنید:
FLANN_INDEX_KDTREE = 1
index_params = dict(algorithm = FLANN_INDEX_KDTREE, trees = 5)
هنگام استفاده از ORB، میتوانید موارد زیر را ارسال کنید. مقادیر کامنتشده طبق مستندات توصیه شدهاند، اما در برخی موارد نتایج مورد نیاز را فراهم نکردند. سایر مقادیر به درستی کار کردند.:
FLANN_INDEX_LSH = 6
index_params= dict(algorithm = FLANN_INDEX_LSH,
                   table_number = 6, # 12
                   key_size = 12,     # 20
                   multi_probe_level = 1) #2
دیکشنری دوم SearchParams است. این دیکشنری تعداد دفعاتی را که درختها در اندیس به صورت بازگشتی پیمایش میشوند مشخص میکند. مقادیر بالاتر دقت بهتری میدهند اما زمان بیشتری میبرند. اگر بخواهید مقدار را تغییر دهید، search_params = dict(checks=100) را ارسال کنید.
با این اطلاعات آمادهایم.
import numpy as np
import cv2 as cv
import matplotlib.pyplot as plt

img1 = cv.imread('box.png',cv.IMREAD_GRAYSCALE)          # queryImage
img2 = cv.imread('box_in_scene.png',cv.IMREAD_GRAYSCALE) # trainImage

# Initiate SIFT detector
sift = cv.SIFT_create()

# find the keypoints and descriptors with SIFT
kp1, des1 = sift.detectAndCompute(img1,None)
kp2, des2 = sift.detectAndCompute(img2,None)

# FLANN parameters
FLANN_INDEX_KDTREE = 1
index_params = dict(algorithm = FLANN_INDEX_KDTREE, trees = 5)
search_params = dict(checks=50)   # or pass empty dictionary

flann = cv.FlannBasedMatcher(index_params,search_params)

matches = flann.knnMatch(des1,des2,k=2)

# Need to draw only good matches, so create a mask
matchesMask = [[0,0] for i in range(len(matches))]

# ratio test as per Lowe's paper
for i,(m,n) in enumerate(matches):
    if m.distance < 0.7*n.distance:
        matchesMask[i]=[1,0]

draw_params = dict(matchColor = (0,255,0),
                   singlePointColor = (255,0,0),
                   matchesMask = matchesMask,
                   flags = cv.DrawMatchesFlags_DEFAULT)

img3 = cv.drawMatchesKnn(img1,kp1,img2,kp2,matches,None,**draw_params)

plt.imshow(img3,),plt.show()
نتیجه را در زیر ببینید: