تشخیص و توصیف ویژگی
مقدمهای بر SIFT (تبدیل ویژگی ناوردا نسبت به مقیاس)
هدف#
در این فصل،
- با مفاهیم الگوریتم SIFT آشنا خواهیم شد.
- نحوه یافتن نقاط کلیدی (Keypoints) و توصیفگرهای (Descriptors) الگوریتم SIFT را یاد خواهیم گرفت.
تئوری#
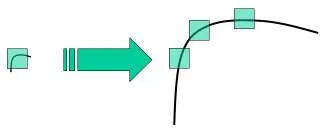
در دو فصل گذشته، چند آشکارساز گوشه مانند هریس و غیره را دیدیم. آنها ناوردا نسبت به چرخش (Rotation-invariant) هستند، به این معنی که حتی اگر تصویر بچرخد، میتوانیم همان گوشهها را پیدا کنیم. این امر بدیهی است زیرا گوشهها در تصویر چرخیدهشده نیز گوشه باقی میمانند. اما در مورد تغییر مقیاس (Scaling) چطور؟ اگر تصویر تغییر مقیاس دهد، یک گوشه ممکن است دیگر گوشه نباشد. به عنوان مثال، تصویر ساده زیر را بررسی کنید: گوشهای در یک تصویر کوچک درون یک پنجره کوچک، وقتی در همان پنجره بزرگنمایی میشود، مسطح است. بنابراین گوشه هریس ناوردا نسبت به مقیاس نیست.
در سال ۲۰۰۴، دی. لووه (D.Lowe) از دانشگاه بریتیش کلمبیا، در مقاله خود با عنوان Distinctive Image Features from Scale-Invariant Keypoints الگوریتم جدیدی به نام تبدیل ویژگی ناوردا نسبت به مقیاس (SIFT) ارائه داد که نقاط کلیدی را استخراج کرده و توصیفگرهای آنها را محاسبه میکند. (این مقاله ساده و قابل فهم است و به عنوان بهترین منبع موجود در مورد SIFT در نظر گرفته میشود. این توضیح صرفاً خلاصه کوتاهی از این مقاله است).
به طور کلی چهار مرحله اصلی در الگوریتم SIFT وجود دارد که آنها را یک به یک بررسی خواهیم کرد.
۱. تشخیص اکسترمم در فضای مقیاس (Scale-space Extrema Detection)#
از تصویر بالا مشخص است که ما نمیتوانیم از پنجره یکسانی برای تشخیص نقاط کلیدی در مقیاسهای مختلف استفاده کنیم. این پنجره برای گوشههای کوچک مناسب است، اما برای تشخیص گوشههای بزرگتر به پنجرههای بزرگتری نیاز داریم. برای این منظور، فیلتر کردن فضای مقیاس استفاده میشود. در آن، لاپلاسین گاوسی (LoG یا Laplacian of Gaussian) برای تصویر با مقادیر مختلف به دست میآید. فیلتر LoG به عنوان یک آشکارساز حباب (Blob Detector) عمل میکند که حبابها را در اندازههای مختلف به دلیل تغییر در تشخیص میدهد. به طور خلاصه، به عنوان یک پارامتر مقیاسبندی عمل میکند. به عنوان مثال، در تصویر فوق، هسته گاوسی با کم مقدار بالایی برای گوشه کوچک میدهد در حالی که هسته گاوسی با زیاد به خوبی برای گوشه بزرگتر برازش میشود. بنابراین، میتوانیم بیشینههای محلی (Local Maxima) را در مقیاس و فضا پیدا کنیم که فهرستی از مقادیر را به ما میدهد که نشان میدهد یک نقطه کلیدی بالقوه در (x,y) در مقیاس وجود دارد.
اما محاسبه این LoG کمی هزینهبر است، بنابراین الگوریتم SIFT از تفاضل گاوسیها (DoG یا Difference of Gaussians) استفاده میکند که تقریبی از LoG است. تفاضل گاوسی به عنوان اختلاف بین تاری گاوسی یک تصویر با دو متفاوت، مثلاً و به دست میآید. این فرآیند برای اکتاوهای (Octaves) مختلف تصویر در هرم گاوسی انجام میشود. این فرآیند در تصویر زیر نشان داده شده است:
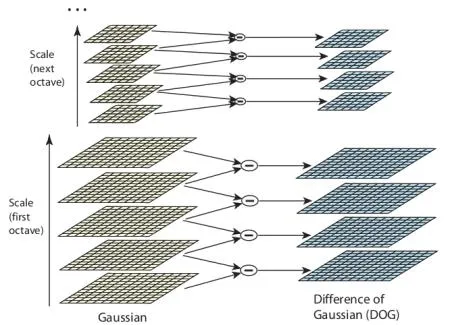
هنگامی که این DoGها پیدا شدند، تصاویر برای یافتن اکسترممهای محلی روی مقیاس و فضا جستجو میشوند. برای مثال، یک پیکسل در یک تصویر با ۸ همسایه خود و همچنین ۹ پیکسل در مقیاس بعدی و ۹ پیکسل در مقیاسهای قبلی مقایسه میشود. اگر یک اکسترمم محلی باشد، یک نقطه کلیدی بالقوه است. این اساساً به این معنی است که نقطه کلیدی در آن مقیاس به بهترین شکل نمایش داده میشود. این موضوع در تصویر زیر نشان داده شده است:
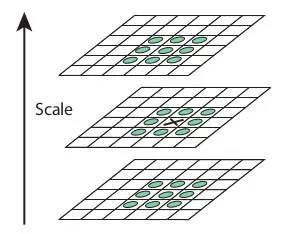
در رابطه با پارامترهای مختلف، مقاله دادههای تجربی ارائه میدهد که میتوان آنها را به این صورت خلاصه کرد: تعداد اکتاوها = ۴، تعداد سطوح مقیاس = ۵، مقدار اولیه ، و غیره به عنوان مقادیر بهینه.
۲. مکانیابی دقیق نقطه کلیدی (Keypoint Localization)#
هنگامی که مکانهای نقاط کلیدی بالقوه پیدا شدند، باید پالایش و اصلاح شوند تا نتایج دقیقتری به دست آید. آنها از بسط سری تیلور فضای مقیاس برای به دست آوردن موقعیت دقیقتر اکسترمم استفاده کردند و اگر شدت روشنایی در این اکسترمم کمتر از مقدار آستانه باشد (طبق مقاله ۰.۰۳)، رد میشود. این آستانه در OpenCV به نام contrastThreshold شناخته میشود.
فیلتر DoG پاسخ بالاتری برای لبهها دارد، بنابراین لبهها نیز باید حذف شوند. برای این کار، مفهومی مشابه آشکارساز گوشه هریس استفاده میشود. آنها از یک ماتریس هسین 2x2 (به نام H) برای محاسبه انحنای اصلی (Principal Curvature) استفاده کردند. ما از آشکارساز گوشه هریس میدانیم که برای لبهها، یک مقدار ویژه بزرگتر از دیگری است. بنابراین در اینجا از یک تابع ساده استفاده کردند:
اگر این نسبت بزرگتر از یک آستانه باشد که در OpenCV به نام edgeThreshold نامیده میشود، آن نقطه کلیدی کنار گذاشته میشود. این مقدار در مقاله برابر ۱۰ ذکر شده است.
بنابراین هر نقطه کلیدی با کنتراست پایین و نقاط کلیدی لبه حذف میشوند و آنچه باقی میماند نقاط با اهمیت قوی هستند.
۳. تخصیص جهت (Orientation Assignment)#
اکنون به هر نقطه کلیدی یک جهت اختصاص داده میشود تا ناوردایی نسبت به چرخش تصویر حاصل شود. همسایگی در اطراف مکان نقطه کلیدی بسته به مقیاس در نظر گرفته میشود و بزرگی و جهت گرادیان در آن ناحیه محاسبه میگردد. یک هیستوگرام جهتگیری با ۳۶ دسته (Bin) که ۳۶۰ درجه را پوشش میدهد ایجاد میشود (این هیستوگرام با بزرگی گرادیان و پنجره دایرهای با وزن گاوسی با برابر با ۱.۵ برابر مقیاس نقطه کلیدی وزندهی میشود). بلندترین قله در هیستوگرام گرفته میشود و هر قلهای بالای ۸۰ درصد آن نیز برای محاسبه جهت در نظر گرفته میشود. این کار نقاط کلیدی با مکان و مقیاس یکسان اما با جهتهای متفاوت ایجاد میکند که به پایداری تطبیق کمک مینماید.
۴. توصیفگر نقطه کلیدی (Keypoint Descriptor)#
اکنون توصیفگر نقطه کلیدی ایجاد میشود. یک همسایگی 16x16 در اطراف نقطه کلیدی گرفته میشود. این ناحیه به ۱۶ زیربلوک به ابعاد 4x4 تقسیم میشود. برای هر زیربلوک، هیستوگرام جهتگیری ۸ دستهای ایجاد میگردد؛ بنابراین در مجموع ۱۲۸ مقدار دسته در دسترس است. این مقادیر به صورت یک بردار برای تشکیل توصیفگر نقطه کلیدی نمایش داده میشوند. علاوه بر این، اقدامات متعددی برای دستیابی به مقاومت در برابر تغییرات روشنایی، چرخش و غیره انجام میگیرد.
۵. تطبیق نقاط کلیدی (Keypoint Matching)#
نقاط کلیدی بین دو تصویر با شناسایی نزدیکترین همسایگان آنها تطبیق داده میشوند. اما در برخی موارد، دومین تطابق نزدیک ممکن است بسیار نزدیک به اولی باشد. این اتفاق ممکن است به دلیل نویز یا دلایل دیگر رخ دهد. در این حالت، نسبت نزدیکترین فاصله به دومین فاصله نزدیک در نظر گرفته میشود. اگر این نسبت بزرگتر از ۰.۸ باشد، رد میشوند. طبق مقاله، این کار حدود ۹۰ درصد از تطابقهای نادرست را حذف کرده در حالی که تنها ۵ درصد از تطابقهای صحیح را کنار میگذارد.
این خلاصهای از الگوریتم SIFT بود. برای جزئیات و درک بیشتر، خواندن مقاله اصلی اکیداً توصیه میشود.
الگوریتم SIFT در OpenCV#
اکنون بیایید قابلیتهای SIFT موجود در OpenCV را ببینیم. توجه داشته باشید که این توابع قبلاً فقط در مخزن opencv contrib در دسترس بودند، اما حق ثبت اختراع (پتنت) آن در سال ۲۰۲۰ منقضی شد. بنابراین اکنون در مخزن اصلی گنجانده شدهاند. بیایید با تشخیص نقاط کلیدی و رسم آنها شروع کنیم. ابتدا باید یک شیء SIFT بسازیم. میتوانیم پارامترهای مختلفی را به آن ارسال کنیم که اختیاری هستند و به خوبی در اسناد توضیح داده شدهاند:
import numpy as np
import cv2 as cv

img = cv.imread('home.jpg')
gray= cv.cvtColor(img,cv.COLOR_BGR2GRAY)

sift = cv.SIFT_create()
kp = sift.detect(gray,None)

img=cv.drawKeypoints(gray,kp,img)

cv.imwrite('sift_keypoints.jpg',img)
تابع ()sift.detect نقاط کلیدی را در تصاویر پیدا میکند. اگر میخواهید فقط بخشی از تصویر را جستجو کنید میتوانید یک ماسک ارسال نمایید. هر نقطه کلیدی ساختار ویژهای است که ویژگیهای زیادی مانند مختصات (x,y)، اندازه همسایگی معنادار، زاویهای که جهت آن را مشخص میکند، پاسخی که قدرت نقاط کلیدی را تعیین میکند و غیره دارد.
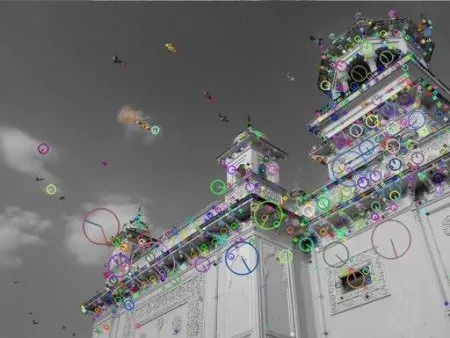
کتابخانه OpenCV همچنین تابع ()cv.drawKeyPoints را ارائه میدهد که دایرههای کوچکی را روی مکانهای نقاط کلیدی رسم میکند. اگر پرچم cv.DRAW_MATCHES_FLAGS_DRAW_RICH_KEYPOINTS را به آن ارسال کنید، دایرهای با اندازه نقطه کلیدی رسم میکند و حتی جهت آن را نیز نشان میدهد. مثال زیر را ببینید:
img=cv.drawKeypoints(gray,kp,img,flags=cv.DRAW_MATCHES_FLAGS_DRAW_RICH_KEYPOINTS)
cv.imwrite('sift_keypoints.jpg',img)
دو نتیجه را در زیر مشاهده کنید:
اکنون برای محاسبه توصیفگر، OpenCV دو روش ارائه میدهد:
- از آنجا که از قبل نقاط کلیدی را پیدا کردهاید، میتوانید ()sift.compute را فراخوانی کنید که توصیفگرها را از نقاط کلیدی که پیدا کردهایم محاسبه میکند. به عنوان مثال: kp,des = sift.compute(gray,kp)
- اگر نقاط کلیدی را پیدا نکردهاید، مستقیماً نقاط کلیدی و توصیفگرها را در یک مرحله با تابع ()sift.detectAndCompute پیدا کنید.
ما روش دوم را خواهیم دید:
sift = cv.SIFT_create()
kp, des = sift.detectAndCompute(gray,None)
در اینجا kp فهرستی از نقاط کلیدی و des یک آرایه numpy به شکل خواهد بود.
بنابراین ما نقاط کلیدی، توصیفگرها و غیره را به دست آوردیم. اکنون میخواهیم ببینیم چگونه نقاط کلیدی را در تصاویر مختلف تطبیق دهیم. این موضوع را در فصول آینده یاد خواهیم گرفت.