یادگیری ماشین
درک خوشهبندی K-Means
هدف#
در این فصل، مفاهیم خوشهبندی K-Means، نحوه کارکرد آن و غیره را درک خواهیم کرد.
تئوری#
ما این موضوع را با مثالی که معمولاً استفاده میشود بررسی خواهیم کرد.
مسئله سایز تیشرت#
شرکتی را در نظر بگیرید که قصد دارد مدل جدیدی از تیشرت را به بازار عرضه کند. بدیهی است که آنها باید مدلهایی را در اندازههای مختلف تولید کنند تا رضایت افراد در تمام اندازهها جلب شود. بنابراین شرکت دادههایی از قد و وزن افراد تهیه کرده و آنها را مطابق شکل زیر روی یک نمودار رسم میکند:
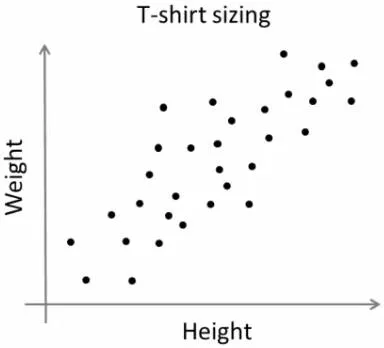
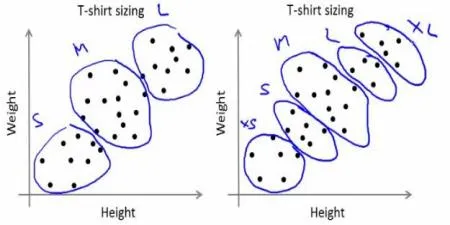
شرکت نمیتواند تیشرتهایی با تمام اندازهها تولید کند. در عوض، آنها افراد را به کوچک (Small)، متوسط (Medium) و بزرگ (Large) تقسیم میکنند و تنها این ۳ مدل را تولید میکنند که مناسب همه افراد باشد. این گروهبندی افراد به سه گروه را میتوان با خوشهبندی k-means انجام داد و الگوریتم بهترین ۳ اندازه را که رضایت همه افراد را جلب میکند در اختیار ما قرار میدهد. و اگر کافی نباشد، شرکت میتواند افراد را به گروههای بیشتری، مثلاً پنج گروه و غیره تقسیم کند. تصویر زیر را بررسی کنید:
چگونه کار میکند؟#
این الگوریتم یک فرآیند تکرارپذیر (Iterative) است. ما آن را گام به گام به کمک تصاویر توضیح خواهیم داد.
مجموعهای از دادهها را مانند زیر در نظر بگیرید (میتوانید آن را به عنوان مسئله تیشرت در نظر بگیرید). ما باید این دادهها را به دو گروه خوشهبندی کنیم.
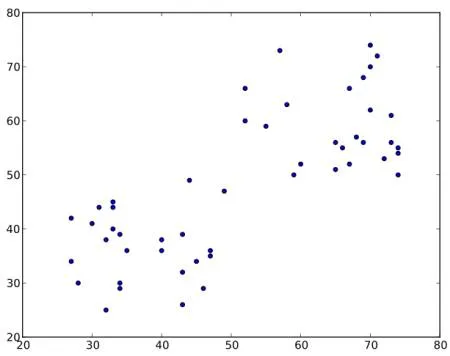
گام ۱ - الگوریتم به صورت تصادفی دو مرکز ثقل (مرکز خوشه یا Centroid)، و را انتخاب میکند (گاهی اوقات، هر دو داده به عنوان مراکز انتخاب میشوند).
گام ۲ - فاصله هر نقطه تا هر دو مرکز محاسبه میشود. اگر یک داده آزمایشی به نزدیکتر باشد، آن داده با '0' برچسبگذاری میشود. اگر به نزدیکتر باشد، با '1' برچسب میخورد (اگر مراکز بیشتری وجود داشته باشد، با '2'، '3' و غیره برچسبگذاری میشوند).
در مورد ما، تمام دادههای با برچسب '0' را به رنگ قرمز، و دادههای با برچسب '1' را به رنگ آبی درمیآوریم. بنابراین پس از عملیات فوق تصویر زیر را به دست میآوریم:
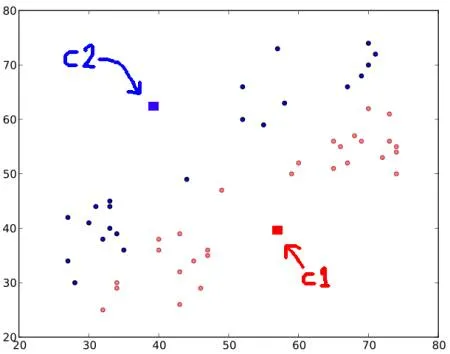
گام ۳ - سپس میانگین تمام نقاط آبی و نقاط قرمز را به طور جداگانه محاسبه میکنیم و آن میانگینها مراکز ثقل جدید ما خواهند بود؛ یعنی و به مراکز جدیدِ محاسبهشده منتقل میشوند. (به یاد داشته باشید، تصاویر نشاندادهشده مقادیر واقعی و در مقیاس واقعی نیستند و صرفاً برای نمایش هستند).
و مجدداً، گام ۲ را با مراکز جدید انجام داده و دادهها را به '0' و '1' برچسبگذاری میکنیم.
بنابراین نتیجه زیر حاصل میشود:
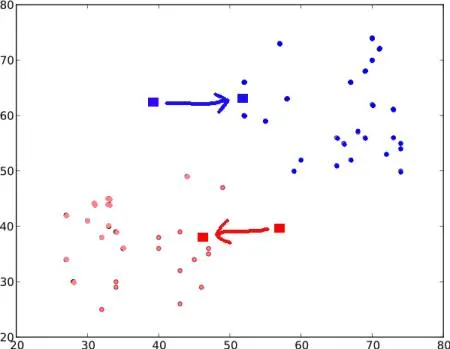
اکنون گام ۲ و گام ۳ تکرار میشوند تا زمانی که هر دو مرکز ثقل به نقاط ثابتی همگرا شوند. (یا ممکن است بسته به معیارهایی که ارائه میدهیم متوقف شود، مانند حداکثر تعداد تکرارها، یا رسیدن به یک دقت مشخص و غیره.) این نقاط به گونهای هستند که مجموع فواصل بین دادههای آزمایشی و مراکز متناظر آنها حداقل باشد. یا به بیان ساده، مجموع فواصل بین و کمینه است.
نتیجه نهایی تقریباً شبیه به تصویر زیر خواهد بود:
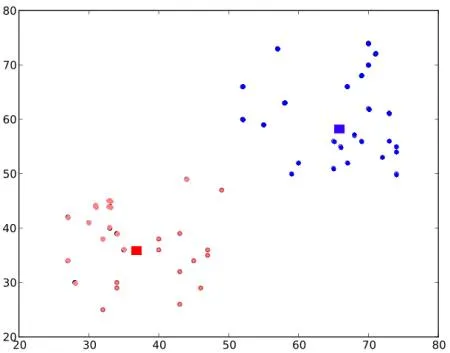
بنابراین این صرفاً یک درک شهودی از خوشهبندی K-Means است. برای جزئیات بیشتر و توضیحات ریاضی، لطفاً هر یک از کتابهای استاندارد یادگیری ماشین را مطالعه فرمایید یا پیوندهای موجود در منابع اضافی را بررسی کنید. این فقط لایه سطحی خوشهبندی K-Means است. اصلاحات زیادی برای این الگوریتم وجود دارد مانند نحوه انتخاب مراکز اولیه، چگونگی افزایش سرعت فرآیند تکرار و غیره.
منابع اضافی#
- دوره یادگیری ماشین، ویدیوهای سخنرانی پروفسور Andrew Ng (برخی از تصاویر از این دوره گرفته شده است)